
AI-vandmærker i tekst: Hvad betyder de for dig?
- AI-vandmærker i tekst: Hvad betyder de egentlig for dig?
- Hvad er et AI-vandmærke?
- Hvordan kan man gemme et vandmærke i almindelige ord?
- Bliver teksterne så dårligere?
- Hvorfor gør EU det her?
- Den vigtige detalje: Hvad hvis du selv har skrevet teksten?
- Korrektur er ikke det samme som at få AI til at skrive teksten
- Hvad med menneskelig redigering bagefter?
- Min praktiske metode til AI-genererede udkast
- Skal du være nervøs for AI-vandmærker?
Der bliver talt en del om AI-vandmærker lige nu.
Og som det så ofte sker med AI-nyheder, er den mest dramatiske udgave også den, der hurtigst finder vej rundt på nettet.
”Nu kommer der usynlige vandmærker i alle tekster fra ChatGPT og Claude.”
”Man vil kunne se, at du har brugt AI.”
”Hvad nu, hvis jeg bare bruger ChatGPT til at rette min egen tekst?”
Det sidste spørgsmål synes jeg faktisk er ret vigtigt.
For jeg bruger selv AI til at arbejde med tekst. Jeg dikterer en tekst og får bagefter AI til at rydde op i tegnsætningen, rette grammatikken, dele teksten i fornuftige afsnit og den slags.
Det gør ikke pludselig teksten til en AI-genereret tekst.
Og det er netop en af de ting, der er værd at få styr på, inden vi gør AI-vandmærker til noget mere mystisk og farligt, end de er.
Hvad er et AI-vandmærke?
Når vi hører ordet ”vandmærke”, tænker de fleste nok på et logo hen over et billede.
Måske et diskret ”Copyright” eller et firmanavn, der gør det lidt besværligt at stjæle billedet.
Men når vi taler om AI-genereret tekst, kan mærkningen være noget helt andet.
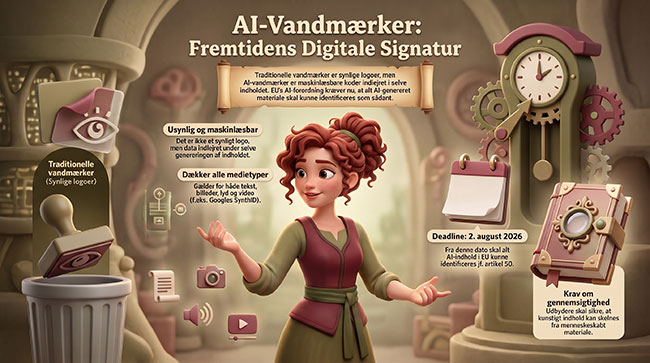
EU’s AI-forordning kræver nu, at udbydere af generative AI-systemer sørger for, at AI-genereret eller AI-manipuleret indhold kan mærkes i et maskinlæsbart format og identificeres som kunstigt genereret eller manipuleret.
Det gælder ikke kun tekst, men også billeder, lyd og video. Reglerne i artikel 50 gælder fra den 2. august 2026.
Det betyder dog ikke, at EU har bestemt, at alle skal bruge én bestemt slags usynligt vandmærke.
Der findes forskellige tekniske muligheder.
Et konkret eksempel er Googles SynthID, som Google allerede bruger til blandt andet AI-genereret tekst fra Gemini. Her er der ikke tale om skjulte bogstaver, mærkelige mellemrum eller en hemmelig kode, som du kan finde ved at åbne teksten i Word og slå ”Vis skjulte tegn” til.
Mærkningen bliver skabt under selve genereringen af teksten.
Hvordan kan man gemme et vandmærke i almindelige ord?
Det lyder umiddelbart lidt mærkeligt.
Hvordan i alverden putter man et usynligt mærke ind i:
”Husk at tilmelde dig kurset senest fredag”?
Man kan ikke nødvendigvis se noget som helst.
Forklaringen ligger i den måde, en sprogmodel skriver på.
Når en AI genererer tekst, sidder den ikke med én færdig sætning i hovedet og skriver den ned. Den vælger løbende mellem forskellige mulige næste dele af teksten, de såkaldte tokens.
Google beskriver selv SynthID Text sådan, at systemet justerer sandsynligheden for, hvilke tokens der bliver valgt under genereringen. Det efterlader et statistisk signal, som Googles detektionssystem efterfølgende kan lede efter.
Jeg synes, det er nemmere at forstå med en lidt forenklet sammenligning.
Forestil dig, at AI’en flere steder i en tekst har forskellige sproglige muligheder, der alle giver mening.
Den kunne måske skrive:
”Det er hendes mest kendte værk.”
eller:
”Det er hendes mest berømte værk.”
Begge sætninger fungerer.
Et tekstvandmærke kan påvirke disse små valg efter et bestemt statistisk system. Ét enkelt ord afslører ingenting. Men i en længere tekst kan summen af mange små valg skabe et mønster, som et egnet detektionssystem kan genkende.
Det er den grundlæggende idé.
Ikke hemmelige bogstaver.
Ikke overvågning af dig.
Og ikke en lille elektronisk sladrehank, der følger dokumentet rundt på internettet.
Bliver teksterne så dårligere?
Det er et rimeligt spørgsmål.
Hvis et system påvirker AI’ens ordvalg for at kunne efterlade et genkendeligt mønster, kunne man jo forestille sig, at resultatet blev dårligere.
Google har undersøgt netop det med SynthID Text.
I et stort forsøg blev omkring 20 millioner svar fra Gemini analyseret. Forskerne fandt ikke en statistisk mærkbar forringelse af brugernes vurdering af de vandmærkede svar sammenlignet med de tilsvarende svar uden vandmærkning. Andre evalueringer fandt heller ikke nogen væsentlig forringelse af tekstkvaliteten.
Det betyder ikke, at enhver tænkelig vandmærkningsteknologi altid vil være perfekt.
Men det viser, at det teknisk er muligt at indbygge et statistisk signal uden at få teksten til at lyde, som om den er skrevet af en embedsmand med slips, stempelur og meget god tid. 😉
Hvorfor gør EU det her?
Formålet er gennemsigtighed.
Generativ AI kan efterhånden fremstille tekst, billeder, lyd og video, som kan være svære at skelne fra menneskeskabt eller autentisk materiale.
Det kan naturligvis bruges til masser af fornuftige ting. Men det kan også bruges til misinformation, svindel, manipulation og deepfakes.
Derfor indeholder artikel 50 i EU’s AI-forordning en række krav om gennemsigtighed.
Udbydere af generative AI-systemer skal blandt andet sørge for maskinlæsbar mærkning af relevant AI-genereret eller AI-manipuleret indhold.
Og professionelle brugere har i bestemte situationer deres egne oplysningspligter. Det gælder blandt andet deepfakes og AI-genereret eller AI-manipuleret tekst om emner af offentlig interesse, når teksten ikke har været underlagt reel menneskelig gennemgang eller redaktionel kontrol.
Så nej. EU har ikke besluttet, at enhver tekst, hvor ChatGPT har flyttet et komma, skal have et stort blinkende:
PAS PÅ – HER HAR VÆRET AI!
Reglerne er noget mere nuancerede end det.
OpenAI, Anthropic og Google har faktisk skrevet under
Omkring 190 organisationer havde ved udgangen af juli 2026 underskrevet EU’s frivillige adfærdskodeks om gennemsigtighed i AI-genereret indhold.
Blandt underskriverne af den relevante del finder vi blandt andre Anthropic, Google, Meta, Microsoft og OpenAI.
Her er det vigtigt at skelne mellem to ting.
Selve kravene i AI-forordningen er lovgivning.
Adfærdskodeksen er frivillig.
Kodeksen giver virksomhederne en praktisk og mere forudsigelig måde at dokumentere, at de lever op til reglerne.
En virksomhed behøver altså ikke underskrive kodeksen, men hvis den lader være, skal den stadig kunne dokumentere, at den overholder de relevante krav på anden vis.
Og hvad så med ChatGPT og Claude?
Her skal vi passe på med at konkludere mere, end vi faktisk ved.
Google har offentliggjort ret detaljerede oplysninger om SynthID og bruger allerede teknologien i Gemini.
Det betyder ikke, at Anthropic og OpenAI nødvendigvis vælger præcis samme teknologi.
EU kræver resultatet: at relevant AI-genereret og AI-manipuleret indhold kan mærkes maskinlæsbart og detekteres på en effektiv, interoperabel, robust og pålidelig måde, så langt det er teknisk muligt.
EU bestemmer ikke, at løsningen skal hedde SynthID.
Derfor ville jeg være meget forsigtig med opslag på nettet, der fortæller præcis, hvordan ”Claudes hemmelige vandmærke” eller ”ChatGPTs usynlige kode” fungerer, medmindre oplysningerne faktisk kommer fra virksomheden selv.
Der er allerede rigeligt med myter om AI. Vi behøver ikke hjælpe flere på vej.
Den vigtige detalje: Hvad hvis du selv har skrevet teksten?
Nu kommer vi til den del, som efter min mening er langt mere interessant for almindelige AI-brugere.
Forestil dig, at jeg sidder og dikterer et blogindlæg.
Ordene og tankerne er mine.
Derefter giver jeg teksten til en AI og siger:
”Ret stavefejl og grammatik. Sæt kommaer. Del teksten i naturlige afsnit. Du må ikke omskrive mine formuleringer eller tilføje nyt indhold.”
Har AI’en så genereret teksten?
Nej. Den har hjulpet med redigeringen.
Og EU-Kommissionens vejledning tager faktisk højde for netop den forskel.
Den maskinlæsbare mærkningspligt gælder ikke, når AI-systemet udfører en assisterende funktion i forbindelse med standardredigering, eller når systemet ikke ændrer inputdata eller deres betydning væsentligt.
Det er en ret vigtig detalje.
For brug af AI er ikke enten:
”AI har aldrig rørt teksten”
eller:
”AI har skrevet det hele.”
Der ligger et meget stort område midt imellem.
Korrektur er ikke det samme som at få AI til at skrive teksten
Hvis du selv har skrevet:
”Jeg holder workshop på tirsdag, og vi skal blandt andet arbejde med ChatGPT og Gemini.”
og beder AI om at rette et manglende komma, har AI ikke overtaget forfatterskabet.
Det samme gælder almindelige redigeringsopgaver, hvor indholdet og betydningen ikke ændres væsentligt.
Men hvis du skriver:
”Skriv et blogindlæg på 1.500 ord om fordelene ved ChatGPT for små virksomheder”
så er situationen naturligvis en anden.
Her producerer AI’en selve teksten.
Og der findes en hel skala mellem de to yderpunkter.
Du kan bede AI om at:
- Omskrive tre sætninger.
- Udvide et afsnit.
- Skrive en bedre indledning.
- Foreslå fem argumenter.
- Forkorte noget.
- Ændre tonen.
- Skrive en konklusion.
Jo mere af selve formuleringen og indholdet AI’en producerer, desto længere bevæger vi os væk fra almindelig korrektur og standardredigering.
Det er egentlig ganske logisk.
Hvad med menneskelig redigering bagefter?
Her er der endnu en vigtig nuance.
Google oplyser, at SynthID Text kan overleve visse mindre ændringer af en tekst, herunder beskæring, ændring af enkelte ord og let parafrasering.
En grundig omskrivning eller oversættelse kan derimod reducere systemets mulighed for at genkende vandmærket betydeligt.
Derfor er det for enkelt at sige:
”Bare skift nogle ord, så er vandmærket væk.”
Det ved vi ikke.
Og det synes jeg faktisk heller ikke bør være målet.
Jeg vil hellere stille et andet spørgsmål:
Er teksten blevet din?
- Har du læst den?
- Har du kontrolleret fakta?
- Har du ændret de formuleringer, du aldrig selv ville bruge?
- Har du tilføjet din egen erfaring?
- Har du fjernet AI-klichéerne?
- Har du taget ansvar for det, der står?
Hvis svaret er ja, har du gjort noget langt vigtigere end at forsøge at narre en AI-detektor.
Du har redigeret din tekst.
Min praktiske metode til AI-genererede udkast
Hvis jeg bruger AI til at lave et egentligt første udkast, ville jeg aldrig bare kopiere teksten direkte og offentliggøre den.
Jeg ville gøre sådan her:
Læs teksten som redaktør
Læs den fra ende til anden. Ikke kun for stavefejl. Kig efter påstande, gentagelser, mærkelige formuleringer og sætninger, du aldrig selv ville sige.
Kontrollér fakta
AI kan stadig tage fejl. En velformuleret sætning er ikke dokumentation for, at indholdet er korrekt.
Datoer, regler, priser, produktnavne, funktioner, undersøgelser og konkrete påstande skal kontrolleres.
Ja, også når AI’en lyder meget overbevisende.
Især dér.
Fjern AI-sproget
Hvis teksten er fuld af ”i en verden i konstant forandring”, ”det er vigtigt at bemærke”, ”udnyt potentialet” og andre formuleringer, som du aldrig ville sige til et menneske, så ud med dem.
Teksten skal lyde som dig.
Tilføj det, AI’en ikke har
- Din erfaring.
- Et eksempel fra en kundeopgave.
- Noget, du selv har prøvet.
- En fejl, du har begået og lært af.
- En holdning.
- En lille detalje fra virkeligheden.
Det er ofte netop dér, teksten går fra at være et pænt AI-udkast til faktisk at være interessant at læse.
Tag ansvar for den færdige tekst
Det sidste punkt er det vigtigste.
Når dit navn står under teksten, er det også dig, der står på mål for den.
AI kan være en glimrende sparringspartner, researcher, korrekturlæser og tekstassistent.
Men ”ChatGPT sagde det” er stadig en elendig kildehenvisning.
Skal du være nervøs for AI-vandmærker?
Nej.
Men du skal vide, at de findes, og at reglerne omkring AI-genereret indhold er blevet mere konkrete.
Artikel 50 gælder fra den 2. august 2026. For visse generative AI-systemer, der allerede var på markedet inden denne dato, gælder en begrænset overgangsperiode for mærkningskravet frem til den 2. december 2026.
Så området er ikke længere bare en diskussion om, hvad EU måske finder på engang.
Reglerne er her.
Men reglerne siger heller ikke, at enhver person, der får ChatGPT til at rette et komma, nu har produceret ”AI-indhold”.
Tværtimod indeholder vejledningen en konkret undtagelse for almindelig assisteret redigering.
Det synes jeg er vigtigt at få frem.
Og nej, et AI-vandmærke er ikke det samme som en AI-detektor
Du har sikkert allerede set tjenester på nettet, hvor du kan indsætte en tekst og få at vide:
”87 % sandsynlighed for AI.”
De skal ikke blandes sammen med den type maskinlæsbar mærkning, vi taler om her.
En almindelig AI-detektor forsøger typisk at gætte, om en tekst ligner noget, en AI kunne have skrevet.
Et vandmærkesystem som SynthID leder efter et signal, der bevidst er blevet indbygget under genereringen.
Det er to meget forskellige ting.
Google understreger selv, at almindelige klassifikationsbaserede AI-detektorer ikke altid fungerer pålideligt på tværs af forskellige typer indhold og platforme og kan fejlklassificere menneskeskrevet tekst.
Så hvis en tilfældig hjemmeside fortæller dig, at din tekst er ”93 % AI”, ville jeg ikke straks omskrive hele mit blogindlæg og gå i panik.
Jeg ville først spørge:
Hvad måler den egentlig?
Det er et langt bedre spørgsmål.
Det vigtigste er stadig det samme
AI-vandmærker ændrer ikke min grundlæggende måde at arbejde med AI på.
Brug AI til det, den er god til.
- Få hjælp til struktur.
- Idéer.
- Research.
- Korrektur.
- Alternative formuleringer.
- Overblik.
- Første udkast.
Men behold hovedet tændt.
- Kontrollér oplysningerne.
- Redigér teksten.
- Tilføj din egen erfaring og faglighed.
- Og tag ansvar for det, du sender ud i verden.
Ikke fordi du skal ”snyde” et vandmærke.
Men fordi teksten skal være din.
Det var en god idé før den 2. august 2026.
Det er det stadig.
Vil du vide mere?
Læs flere indlæg om AI
Fra Custom GPT til Skills
AI Agenter – Human in the loop

Hemmelige Claude kommandoer

NotebookLM kursus Google AI oversigt

Menneske med i processen

Stop med at sælge mig AI-hemmeligheder – der findes ingen

Når AI lyder overbevisende – men fakta ikke følger med

AI-parallel til Lord of the Rings inskription

6 AI-myter punkteret af en IT-instruktør
Kom på mit Nyhedsbrev:

Certifikater:

Hvis du har en IT-opgave, som du vil lære at løse, så lærer jeg dig det.
Hvis du hellere vil koncentrere dig om dét du er god til, så løser jeg opgaven for dig.
Tekst, grafik, billeder, lyd og andet indhold på dette website er beskyttet efter lov om ophavsret. Heidi Bille forbeholder sig alle rettigheder til indholdet, herunder retten til at udnytte indholdet med henblik på tekst- og datamining, jf. ophavsretslovens § 11 b og DSM-direktivets artikel 4.
Copyright 2026 © Heidi Bille
